주니어 백엔드 개발자가 반드시 알아야 할 실무 지식을 읽고
모놀리식 서비스를 MSA로 옮기는 일을 맡으면서, AI에게 정확하게 일을 시키려면 백엔드 실무 감각부터 있어야 한다는 걸 느꼈다. Spring과 Java로 쓰인 책을 Node.js 개발자의 눈으로 읽으며 타임아웃, 비동기 연동, 트랜잭션 아웃박스, 인증과 인가까지 재밌었던 토픽들을 코드와 함께 기록한다.
이 책을 읽게 된 계기
결론부터 말하면 — AI에게 정확하게 일을 시키려고 읽었다.
회사에서 플랫폼 엔지니어링을 맡게 되었다. 사내 서비스는 대부분 모놀리식으로 되어 있고, 이걸 MSA(Microservice Architecture)로 전환하는 일을 내가 도맡아서 하게 됐다.
프론트엔드로서의 역량은 어느 정도 생겼다고 생각한다. 그런데 이번 일은 결이 다르다. 인프라를 만지고, 다른 서비스들이 기대도 될 만큼 신뢰 있는 서비스를 만들어야 한다.
MSA는 유연함을 준다. 서비스마다 따로 배포하고, 따로 확장한다. 대신 대가가 있다. 하나가 흔들리면 그 서비스를 부르는 모든 서비스가 같이 흔들린다. 모놀리식에서는 함수 호출이던 것이 MSA에서는 네트워크 호출이 된다. 함수 호출은 느려지지도 않고 중간에 사라지지도 않는다. 네트워크 호출은 둘 다 한다.
그리고 솔직한 사정이 하나 더 있었다. 팀 내 시니어분들 중에 외부 API 연동이나, 이런 플랫폼을 통해 실제 트래픽을 받아본 사람이 많지 않았다. 물어볼 곳이 마땅치 않았다.
내 몸은 내가 챙겨야 했다.
AI로만 개발하면 생기는 한계
요즘 코드는 AI가 작성한다. 그러면 개발자에게 남는 건 검토와 판단이다.
그런데 AI로만 개발하다 보니 한계가 바로 드러났다. 정확하게 명령을 내릴 수가 없었다.
- 이 외부 API가 3초 동안 응답이 없으면 어떻게 해야 하는지
- 실패하면 재시도를 해야 하는지, 해도 되는지
- 이 작업을 사용자가 기다려야 하는지
이런 걸 내가 모르니까 AI에게 시킬 수가 없다. "외부 API 연동해줘"라고 하면 AI는 정말로 연동만 해준다. 타임아웃도, 재시도 정책도, 실패했을 때 데이터가 어떻게 남는지도 내가 묻지 않으면 없다. 챙겨주더라도 그게 이 상황에 맞는지 내가 판단을 못 한다.
코드 품질도 마찬가지고, 상황에 맞는 유연한 대책이나 예외 처리도 마찬가지다.
그래서 필요했던 건 실무에서 자주 나오는 트러블슈팅과 경험에 대한 객관적인 시야였다. 직접 다 겪어보기엔 시간이 없고, 겪고 나서 배우기엔 장애가 너무 비싸다.
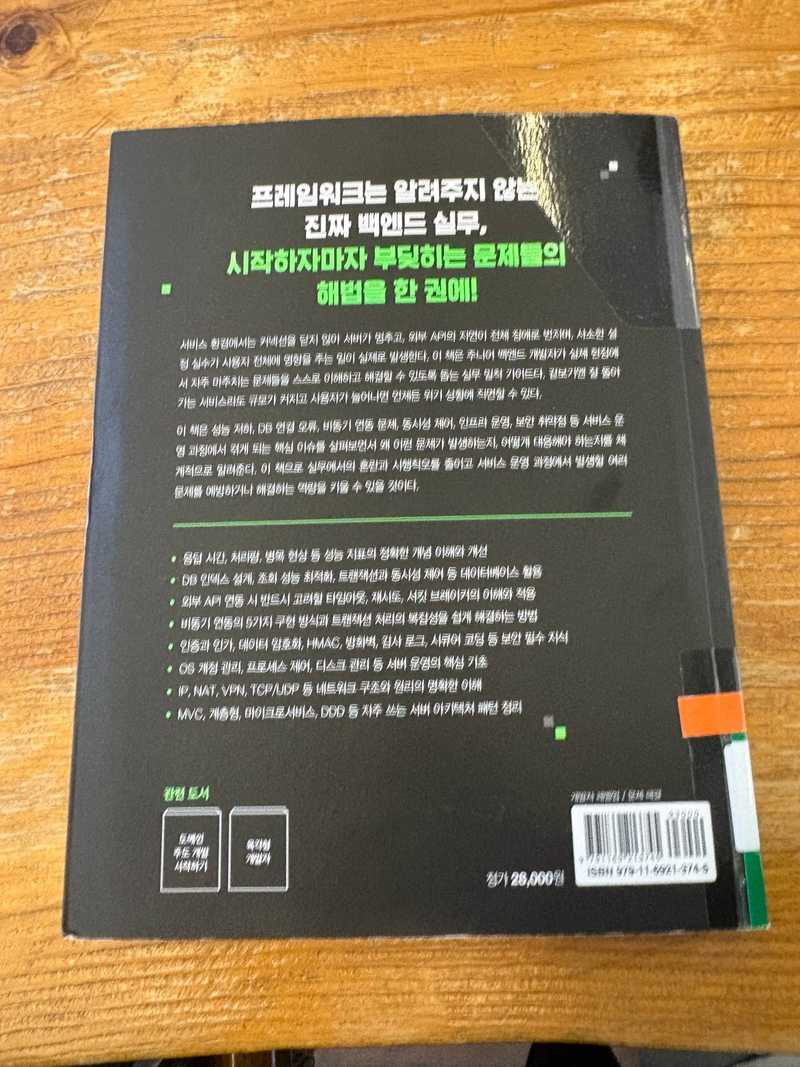
프레임워크는 알려주지 않는 진짜 백엔드 실무, 시작하자마자 부딪히는 문제들의 해법을 한 권에!
뒷표지 문구가 내가 찾던 것과 정확히 같았다.
Spring과 Java로 쓰여 있지만
예제는 전부 Spring과 Java다. 나는 주로 Node.js를 쓴다.
그런데 오히려 그래서 재밌었다. 개발자는 다른 언어와 프레임워크도 배워봐야 한다고 생각한다. 같은 문제를 다른 런타임은 어떻게 푸는지 보면, 내가 쓰는 런타임이 더 잘 보인다.
그래서 이 글의 코드는 책의 Java 예제를 그대로 옮기지 않고, 내가 쓰는 TypeScript와 Node.js로 다시 써봤다. 책을 읽으면서 "Node.js에서는 이게 어떻게 되지?"를 계속 물었던 흔적이다.
이 책은 정말 재밌게 읽었다. 아래는 토픽별로 재밌었던 것, 인상 깊었던 것을 두루 적은 기록이다. 요약이 아니니 궁금하면 책을 직접 읽어보길 권한다.
성능 — 느리다는 말을 쪼개기
응답 시간, 처리량, 병목 현상 등 성능 지표의 정확한 개념 이해와 개선
"서비스가 느려요"라는 말은 너무 넓다. 책은 이걸 쪼갠다.
- 응답 시간 — 요청 하나가 끝나기까지 걸리는 시간
- 처리량 — 단위 시간당 처리할 수 있는 요청 수. 보통 TPS(Transactions Per Second)로 표현한다.
- 병목 — 전체 흐름에서 가장 좁은 구간
응답 시간과 처리량은 다른 이야기다. 한 명이 쓸 때 0.1초 걸리는 서비스도, 천 명이 동시에 쓰면 줄을 서느라 3초가 걸린다. 응답 시간이 느려진 게 아니라 처리량이 모자란 거다.
이게 숫자로 보이니까 재밌었다. 예를 들어 DB 커넥션 풀이 10개이고, 요청 하나가 커넥션을 100ms 동안 쥐고 있다고 하자.
- 커넥션 하나가 1초에 처리할 수 있는 요청 = 10개
- 커넥션 10개 = 1초에 최대 100개
그러니까 이 서버의 처리량 상한은 100 TPS다. 초당 150개가 들어오면 50개는 커넥션을 기다리며 줄을 선다. 이때 서버를 두 대로 늘리면 어떻게 될까. 서버마다 풀이 10개씩이니 DB 입장에서는 커넥션이 20개로 늘어난다. DB가 그걸 버틸 수 있다면 처리량이 오르고, 못 버티면 DB 앞에 줄 서는 사람만 늘어난다.
병목이 어디인지 모르고 서버를 늘리면 엉뚱한 곳에 돈을 쓴다. 오히려 DB가 먼저 죽는다.
프론트엔드에서 렌더링 성능을 볼 때도 비슷했다. 무턱되고 해당 렌더링이 잘 못 되었다고 로직을 고쳐달라고 AI에게 말하면, 단순히 useMemo와 useCallback을 붙여서 렌더링 횟수를 줄이는 식으로 엉뚱한 곳을 고친다. 또는 우회하는 방식에 설계를 바꿔서 근본 원인이 무엇인지도 모르고 고쳐간다. 물론 AI 성능이 좋아 고쳐달라고 하면 지금도 잘 고쳐준다. 근데 무엇을 고쳤고 원인이 뭐였고, 왜 고쳤는지 알고 있다면, 나중에 다른 곳에서 비슷한 문제가 생겼을 때 훨씬 빠르게 대응할 수 있다.
백엔드도 마찬가지다. 어디가 좁은지 먼저 재야 한다.
DB — 커넥션과 잠금
DB 인덱스 설계, 조회 성능 최적화, 트랜잭션과 동시성 제어 등 데이터베이스 활용
이 부분은 앞서 Real MySQL을 읽으면서 정리한 내용과 많이 겹쳤다. 덕분에 훨씬 잘 읽혔다.
Real MySQL이 "DB가 내부에서 어떻게 동작하는가"라면, 이 책은 "그래서 실무에서 어디서 터지는가"에 가깝다. 같은 개념을 다른 높이에서 보니까 비로소 연결이 됐다.
재고 1개, 주문 2개
동시성 부분이 특히 재밌었다. 재고가 1개 남은 상품을 두 사람이 동시에 주문한다.
const product = await db.product.findUnique({ where: { id } });
if (product.stock < 1) throw new Error('품절');
// A와 B가 동시에 여기까지 왔다면 둘 다 stock = 1을 봤다await db.product.update({  where: { id },  data: { stock: product.stock - 1 },});
A도 재고 1을 보고, B도 재고 1을 본다. 둘 다 통과한다. 둘 다 stock = 0으로 저장한다. 주문은 두 건인데 재고는 하나만 줄었다.
막는 방법은 두 가지다.
- 비관적 잠금 — 읽을 때부터 잠근다.
SELECT ... FOR UPDATE. 다른 트랜잭션은 내가 끝날 때까지 기다린다. - 낙관적 잠금 — 잠그지 않고, 저장할 때 그 사이에 누가 바꿨는지 확인한다.
// 낙관적 잠금const product = await db.product.findUnique({ where: { id } });
if (product.stock < 1) throw new Error('품절');
const { count } = await db.product.updateMany({  where: { id, version: product.version }, // 내가 읽은 버전 그대로일 때만  data: { stock: { decrement: 1 }, version: { increment: 1 } },});
if (count === 0) throw new Error('다른 주문과 충돌했다. 다시 시도');
둘 중 뭘 고를지는 충돌이 얼마나 자주 일어나느냐에 달려 있다. 충돌이 드물면 낙관적 잠금이 싸다. 한정 판매처럼 충돌이 잦으면 매번 실패하고 다시 시도하느니 처음부터 줄을 세우는 비관적 잠금이 낫다.
사실 내가 책을 읽는 이유는 다음과 같다. 처음 학습하게 되면 기계적으로 외우게 된다. 비관적은 잠금을 먼저 하는 방식이고 낙관적 잠금은 실제 잠금 없이 비교를 통해 수정하는 방식.
이 차이를 알아야한다. '비관적'은 실패할 가능성이 높아서 비관적이다. 다수가 데이터 변경을 시도하면 데이터를 정상적으로 변경할 가능성이 떨어지니 이를 비관적이라고 표현한 것이다. '낙관적'은 반대로 성공할 가능성이 높아서 낙관적이다.
책에서 이야기한다. "트랜잭션 범위 내에서 외부 시스템과 연동해야 한다면, 비선점 잠금보다는 선점 잠금을 고려하는 것이 좋다. 예를 들어 주문 취소 과정에서 외부 PG 시스템을 호출해서 결제까지 함께 취소해야 하는 상황을 생각해보자. 이때 비선점 잠금을 사용하면 결제는 이미 취소됐는데, 데이터 변경에 실패해서 트랜잭션이 롤백되는 문제가 발생할 수 있다."
정답이 아니라 상황이 고른다. 이 책에서 계속 반복되는 태도다.
외부 연동 — 남의 장애가 내 장애가 되지 않게
외부 API 연동 시 반드시 고려할 타임아웃, 재시도, 서킷 브레이커의 이해와 적용
이 책을 고른 이유의 절반이 여기 있었다. MSA로 가면 모든 서비스가 서로에게 외부 API다.
타임아웃
타임아웃이 없으면 외부 서비스가 느려질 때 내 서비스도 같이 느려진다. 요청이 쌓이고, 커넥션이 묶이고, 결국 내 서비스도 응답을 못 한다.
const res = await fetch(`${PAYMENT_API}/payments`, { method: 'POST', body });이 코드는 상대방이 응답하지 않으면 하염없이 기다린다. 상대방이 30초 동안 멈춰 있으면, 그 30초 동안 들어온 요청이 전부 같이 멈춘다.
const res = await fetch(`${PAYMENT_API}/payments`, { method: 'POST', body, signal: AbortSignal.timeout(3000), // 3초 안에 답이 없으면 포기한다});한 줄 차이다. 그런데 이 한 줄이 "상대가 느려지면 나도 느려진다"를 "상대가 느려지면 3초 뒤에 실패한다"로 바꾼다. 실패는 처리할 수 있다. 멈춤은 처리할 수 없다.
책에서 인상 깊었던 건, 타임아웃이 연결 타임아웃과 읽기 타임아웃으로 나뉜다는 이야기였다. 연결 자체가 안 되는 상황과, 연결은 됐는데 응답이 안 오는 상황은 다르다. 그리고 몇 초로 잡을지는 감이 아니라 상대 서비스의 평소 응답 시간을 보고 정해야 한다.
재시도
재시도는 생각보다 위험했다.
결제 요청이 타임아웃 났다고 다시 보내면 어떻게 될까. 사실은 첫 번째 요청이 성공했는데 응답만 늦었던 것일 수 있다. 그러면 두 번 결제된다.
그래서 재시도하기 전에 먼저 물어야 한다. 이 요청은 여러 번 보내도 결과가 같은가. 이걸 멱등성(Idempotency)이라고 한다.
- 조회는 백 번 해도 결과가 같다. 재시도해도 된다.
- 결제, 포인트 지급은 보낼 때마다 결과가 쌓인다. 그냥 재시도하면 안 된다.
멱등하지 않은 요청을 재시도하고 싶으면 요청에 고유한 키를 붙여서, 받는 쪽이 "이미 처리한 요청"을 걸러내게 만든다.
await fetch(`${PAYMENT_API}/payments`, { method: 'POST', headers: { 'Idempotency-Key': orderId }, // 같은 주문이면 같은 키 body, signal: AbortSignal.timeout(3000),});그리고 재시도는 간격을 두고, 횟수를 제한한다. 상대가 힘들어서 느린 건데 바로바로 다시 보내면 상대를 더 힘들게 만든다.
서킷 브레이커
서킷 브레이커는 두꺼비집 같은 것이다. 외부 서비스가 계속 실패하면 아예 호출을 끊고 바로 실패를 돌려준다.
- 닫힘(Closed) — 정상. 요청을 그대로 보낸다.
- 열림(Open) — 실패가 일정 비율을 넘었다. 요청을 보내지 않고 바로 실패한다.
- 반열림(Half-Open) — 시간이 좀 지났다. 몇 개만 보내서 살아났는지 본다. 성공하면 닫고, 실패하면 다시 연다.
죽어가는 서비스를 계속 두드리지 않는 것, 그게 상대방에게도 나에게도 낫다. 상대는 회복할 시간을 얻고, 나는 3초씩 기다리던 걸 0초로 줄인다.
외부 연동을 DB 트랜잭션 안에 넣지 말 것
AI는 동시성에 약하고 레이어 바같에 있는 코드는 context를 이해하지 못 한다. (당연한 이야기)
await db.$transaction(async (tx) => { const order = await tx.order.create({ data }); await paymentClient.pay(order); // 외부 호출이 트랜잭션 안에 있다 await tx.order.update({ where: { id: order.id }, data: { status: 'PAID' } }); // 만약 여기서 실패한다면? 롤백하는데 그 때 외부 PG는 ? 이건 안 돌려줄텐데.});외부 결제 API가 3초 걸리면, 그 3초 동안 DB 커넥션 하나를 쥐고 있는다. 앞에서 계산한 그 커넥션 풀이 외부 서비스 속도에 묶인다. 결제사가 느려지면 결제와 아무 상관 없는 조회 API까지 커넥션을 못 받는다.
게다가 결제는 성공했는데 그다음 update에서 실패하면 트랜잭션은 롤백된다. 우리 DB에는 주문이 없는데 돈은 나갔다. DB 롤백은 외부 시스템까지 되돌려주지 않는다.
외부 호출은 트랜잭션 밖으로 빼고, 실패했을 때 어떻게 맞출지를 따로 설계해야 한다.
맞추는 예시
// 주문을 먼저 확정 저장한다.const order = await db.order.create({  data: { ...data, status: 'PENDING' },});
// 외부 결제 호출은 트랜잭션 밖에서 실행한다.await paymentClient.pay({  orderId: order.id,  amount: order.amount,  idempotencyKey: order.id,});
// 여기서 실패해도 주문은 PENDING으로 남는다.await db.order.update({  where: { id: order.id },  data: { status: 'PAID' },});
// 별도 주기 작업: PG 결과와 DB 상태를 맞춘다.async function reconcilePendingOrders() {  const orders = await db.order.findMany({    where: { status: 'PENDING' },  });
  for (const order of orders) {    const payment = await paymentClient.getPayment({      orderId: order.id,    });
if (payment.status === 'SUCCEEDED') { await db.order.updateMany({ where: { id: order.id, status: 'PENDING' }, data: { status: 'PAID' }, }); } }}비동기 연동 — 회원가입 포인트 예제
비동기 연동의 5가지 구현 방식과 트랜잭션 처리의 복잡성을 쉽게 해결하는 방법
이 책에서 제일 재밌게 읽은 부분이다.
회원가입을 하면 포인트를 준다. 흔한 요구 사항이다. 그런데 포인트 지급까지 await로 기다리면 어떻게 될까.
async function signUp(input: SignUpInput) { const user = await userRepository.create(input); await pointService.give(user.id, 1000); // 포인트 서버가 느리면 가입도 느려진다 return user;}사용자는 가입 버튼을 눌렀을 뿐인데, 포인트 서버가 느리면 가입도 느려진다. 포인트 서버가 죽으면 가입도 실패한다. 포인트는 부가 기능인데 핵심 기능의 발목을 잡는다.
질문을 바꿔야 한다. 사용자가 포인트 지급이 끝날 때까지 기다려야 하는가? 아니다. 가입만 되면 된다. 포인트는 조금 늦게 들어와도 된다.
그러면 이 부분은 await 하지 않고 비동기로 넘긴다. 대신 실패 처리는 확실하게 한다.
async function signUp(input: SignUpInput) {  const user = await userRepository.create(input);
  pointService.give(user.id, 1000).catch((error) => {    logger.error({ userId: user.id, error }, '가입 포인트 지급 실패');  });
return user;}Node.js에서 조심할 것
여기서 Node.js라서 조심할 게 하나 있다. await 하지 않은 Promise는 바깥의 try/catch가 잡아주지 못한다.
try { pointService.give(user.id, 1000); // await가 없다} catch (error) { // 여기는 절대 오지 않는다}try 블록은 Promise를 만들자마자 끝난다. 실패는 나중에 일어난다. 그때는 이미 try 밖이다.
그래서 .catch()를 Promise에 직접 붙여야 한다. 이걸 빼먹으면 Unhandled Rejection이 되고, Node.js 15부터는 기본적으로 프로세스가 죽는다.
포인트 하나 못 줬다고 서버 전체가 죽는 셈이다. 가입을 지키려고 비동기로 뺐는데, 정확히 반대 결과가 돌아온다.
이렇게 "기다릴 것"과 "기다리지 않을 것"을 나누는 감각이 이번 책에서 얻은 가장 큰 수확이다. 이전에 실용주의 프로그래머를 읽고 시간적 결합 이야기를 쓴 적이 있는데, 그게 백엔드에서는 이런 모습으로 나타난다.
트랜잭션 아웃박스 패턴
위 After 코드도 완벽하지 않다. 로그만 남기고 끝이다. 그리고 서버가 give()를 호출하기 직전에 배포로 내려가면 포인트는 영영 안 들어간다. 로그에도 안 남는다.
책은 비동기 연동을 구현하는 방법을 여러 가지로 나눠서 보여준다. 별도 스레드로 실행하기, 메시징, 트랜잭션 아웃박스, 배치, CDC(Change Data Capture). 그중 트랜잭션 아웃박스 패턴이 정말 재밌었다.
문제의 핵심은 이거다. DB에 쓰는 일과 메시지를 보내는 일을 한 번에 성공시키기가 어렵다.
- DB 저장 성공 → 메시지 발송 실패: 가입은 됐는데 포인트가 안 들어온다.
- 메시지 발송 성공 → DB 저장 실패: 없는 회원에게 포인트가 들어간다.
아웃박스 패턴은 이 두 일을 둘 다 DB에 쓰는 일로 바꿔서 풀어버린다.
async function signUp(input: SignUpInput) {  return db.$transaction(async (tx) => {    const user = await tx.user.create({ data: input });
    await tx.outbox.create({      data: {        type: 'USER_SIGNED_UP',        payload: { userId: user.id, point: 1000 },      },    });
    return user;  });}
회원 저장과 메시지 저장이 한 트랜잭션이다. 둘 다 되거나 둘 다 안 된다. 가입은 됐는데 메시지가 사라지는 상황이 없다.
async function relayOutbox() {  const messages = await db.outbox.findMany({    where: { sentAt: null },    orderBy: { id: 'asc' },    take: 100,  });
  for (const message of messages) {    await publisher.publish(message.type, message.payload);    await db.outbox.update({      where: { id: message.id },      data: { sentAt: new Date() },    });  }}
이 릴레이는 주기적으로 돈다. 발송에 실패하면 sentAt이 비어 있으니 다음 차례에 다시 보낸다. 서버가 중간에 죽어도 outbox 테이블에 기록이 남아 있으니 살아나서 이어서 보낸다.
대신 공짜는 아니다. publish는 성공했는데 update 직전에 죽으면 같은 메시지를 한 번 더 보낸다. 그래서 받는 쪽은 같은 메시지를 두 번 받아도 괜찮게, 즉 멱등하게 만들어야 한다. 앞에서 본 멱등성 이야기가 여기서 다시 나온다.
"한 번도 안 가는 것"보다 "두 번 갈 수도 있는 것"이 낫다. 두 번은 받는 쪽에서 거를 수 있지만, 안 간 건 아무도 모른다.
이게 너무 깔끔해서 읽다가 감탄했다. MSA로 가면 서비스 간에 이런 이벤트가 끊임없이 오간다. 메시지 하나가 사라지면 데이터가 서비스마다 어긋난다. 앞으로 계속 쓰게 될 패턴이다.
이외에도 재밌는 게 굉장히 많았다. 이 챕터 하나만 다시 읽어도 될 정도다.
IO 병목 — Node.js와 JVM은 서로 반대편에 있었다
네트워크 IO와 블로킹, 가상 스레드, 논블로킹 IO
이 책을 읽으면서 싱글 스레드인 Node.js와 그 반대편에 있는 Java의 JVM의 차이를 제대로 알게 됐다.
전통적인 Java 서버는 요청 하나에 스레드 하나를 붙인다. 그 스레드가 DB나 외부 API 응답을 기다리는 동안 아무것도 못 하고 멈춰 있다. 이게 블로킹이다.
스레드 풀이 200개라고 하자. 외부 API가 느려져서 요청마다 2초씩 기다리면, 200개 스레드가 전부 기다리는 데 쓰인다. CPU는 놀고 있는데 새 요청은 받을 스레드가 없어서 줄을 선다.
그래서 Java 진영은 가상 스레드, 논블로킹 IO 같은 방법으로 블로킹을 피하려고 싸운다. 가상 스레드는 기다리는 동안 실제 스레드를 놓아주니까, 적은 수의 스레드로 많은 요청을 기다릴 수 있다.
Node.js는 출발점이 반대다. 스레드 하나가 이벤트 루프를 돌리고, IO는 기본이 논블로킹이다. 기다리는 동안 다른 요청을 처리한다. 2초씩 걸리는 외부 API를 만 개 기다려도 스레드는 하나면 된다.
대신 그 스레드 하나를 CPU 작업으로 붙잡으면 모든 요청이 멈춘다.
app.get('/report', (req, res) => { const result = heavyCalculation(bigData); // 2초 걸리는 동기 계산 res.json(result);});이 2초 동안 Node.js 서버는 다른 어떤 요청에도 응답하지 못한다. 헬스 체크조차 실패한다. 그래서 Node.js는 이벤트 루프를 막지 않으려고 싸운다. 무거운 계산은 Worker Thread로 보내거나 아예 다른 서비스로 뺀다.
| 전통적인 Java 서버 | Node.js | |
|---|---|---|
| 기본 모델 | 요청마다 스레드 | 스레드 하나 + 이벤트 루프 |
| IO 대기 | 스레드가 멈춰서 기다린다 | 기다리는 동안 다른 요청을 처리한다 |
| 약점 | 기다리는 스레드가 쌓인다 | CPU 작업 하나가 전부를 멈춘다 |
| 싸우는 대상 | 블로킹 | 이벤트 루프 점유 |
같은 문제를 반대 방향에서 풀고 있었다. Java는 기다리는 스레드가 많아서 문제고, Node.js는 스레드가 하나라서 문제다.
Node.js만 썼다면 "원래 비동기니까"로 넘어갔을 것이다. 반대편을 보고 나서야 내가 쓰는 런타임이 왜 이렇게 생겼는지 알게 됐다. 다른 언어를 배워야 하는 이유가 이거다.
보안과 네트워크
보안과 네트워크 챕터는 노트를 제일 많이 썼다. 프론트엔드만 할 때는 몰라도 됐던 것들이고, 지금은 모르면 일을 못 하는 것들이다.
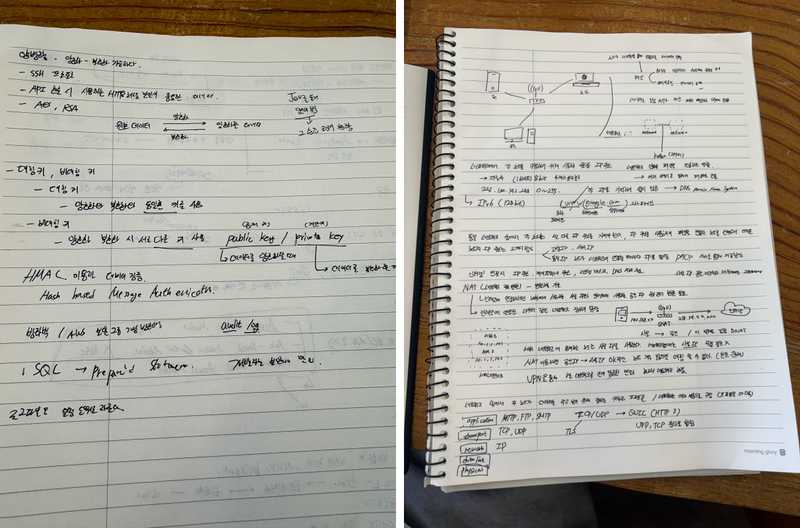
암호화 — 대칭키와 비대칭키
인증과 인가, 데이터 암호화, HMAC, 방화벽, 감사 로그, 시큐어 코딩 등 보안 필수 지식
노트 왼쪽에 적은 것들이다.
- 양방향 암호화 — 암호화하고 다시 복호화할 수 있다. SSH나 HTTPS처럼 API 호출 시 쓰는 통신 보안의 중요한 기반이다. AES, RSA가 대표적이다.
- 대칭키 — 암호화와 복호화에 같은 키를 쓴다. 빠르지만, 그 키를 상대에게 어떻게 안전하게 건네줄지가 문제다.
- 비대칭키 — 서로 다른 키를 쓴다. 공개 키로 암호화한 건 개인 키로만 풀 수 있다. 반대로 개인 키로 서명한 건 공개 키로 누구나 검증할 수 있다.
비대칭키의 이 두 번째 성질이 JWT 서명과 바로 이어진다. 이건 아래 Keycloak 이야기에서 다시 나온다.
HMAC — 이 메시지가 중간에 바뀌지 않았는가
HMAC(Hash-based Message Authentication Code)은 비밀 키와 메시지를 섞어서 해시를 만든다. 받는 쪽은 같은 키로 다시 해시를 만들어 비교한다. 같으면 메시지가 중간에 바뀌지 않았고, 키를 아는 쪽이 보냈다는 뜻이다.
외부 서비스에서 웹훅을 받을 때 이걸 쓴다. 아무나 우리 웹훅 URL로 "결제 완료"를 보낼 수 있으면 안 되니까.
import { createHmac, timingSafeEqual } from 'node:crypto';
function verifySignature(rawBody: string, signature: string, secret: string) {  const expected = createHmac('sha256', secret).update(rawBody).digest('hex');
return ( expected.length === signature.length && timingSafeEqual(Buffer.from(expected), Buffer.from(signature)) );}===로 비교하지 않고 timingSafeEqual을 쓰는 이유도 재밌다. ===는 앞에서부터 비교하다가 다른 글자가 나오면 바로 멈춘다. 그러면 몇 번째 글자까지 맞았는지에 따라 응답 시간이 미세하게 달라지고, 공격자는 그 시간 차이로 서명을 한 글자씩 맞춰갈 수 있다. 비교 시간을 항상 똑같이 만들어서 그 단서를 없앤다.
SQL 인젝션 — 개발자가 제일 먼저 챙길 것
노트에 Prepared Statement 한 줄만 크게 적어둔 부분이다.
await db.$queryRawUnsafe(`SELECT * FROM users WHERE email = '${email}'`);email에 ' OR '1'='1을 넣으면 모든 회원이 나온다. 사용자 입력이 SQL 문장의 일부가 되어버린 거다.
await db.$queryRaw`SELECT * FROM users WHERE email = ${email}`;Prepared Statement는 SQL 문장의 모양을 먼저 확정하고, 값은 나중에 따로 넣는다. 값이 아무리 이상해도 문장의 모양을 바꿀 수 없다. ORM을 쓰면 대부분 알아서 해주지만, 위처럼 Raw 쿼리로 내려가는 순간 다시 내 책임이 된다. AI가 성능 때문에 Raw 쿼리를 쓰자고 제안할 때 제일 먼저 확인해야 할 부분이다.
인증과 인가, 그리고 Keycloak
이 챕터는 지금 하고 있는 일과 바로 맞닿아 있다. 사내에 SSO(Single Sign-On)를 Keycloak으로 만들고 있다. 목표는 각 서비스가 클라이언트로 자연스럽게 등록되고, 인증과 인가를 따로 고민하지 않고 쓸 수 있게 하는 것이다.
그러려면 내가 먼저 알아야 했다.
- 인증(Authentication) — 너 누구야? 실패하면 401.
- 인가(Authorization) — 너 이거 해도 돼? 실패하면 403.
둘은 자주 섞여서 불리지만 다른 질문이다. 로그인은 됐는데 관리자 페이지에 못 들어가는 건 인증은 통과했고 인가에서 막힌 거다. SSO는 인증을 한 곳으로 모으는 일이고, 인가는 여전히 각 서비스가 자기 규칙으로 판단해야 한다. 이 경계를 어디에 둘지가 지금 제일 많이 고민하는 부분이다.
그리고 앞에서 본 비대칭키가 여기서 다시 나온다. Keycloak은 토큰을 개인 키로 서명하고, 각 서비스는 Keycloak이 공개한 공개 키로 그 서명을 검증한다. 그래서 서비스들은 요청마다 Keycloak에 "이 토큰 진짜야?"라고 묻지 않아도 된다. 공개 키만 있으면 스스로 확인할 수 있다.
MSA에서 이게 중요한 이유가 있다. 서비스가 열 개인데 요청마다 열 개가 전부 인증 서버에 물어보면, 인증 서버가 모든 서비스의 병목이 된다. 인증 서버가 죽으면 전부 죽는다. 앞에서 읽은 외부 연동 이야기가 그대로 반복되는 셈이다.
사용자가 아니라 서비스끼리 호출할 때는 또 다르다. 사람이 로그인하는 게 아니라 서비스가 자기 자격 증명으로 토큰을 받아야 한다. Keycloak에서는 이걸 Client Credentials 방식으로 푼다.
모르면 Keycloak 설정 화면의 옵션 하나도 자신 있게 고를 수가 없다. 이 부분은 아직도 계속 학습 중이다. 어렵지만 재밌다.
네트워크 — fetch 한 줄 뒤에서 일어나는 일
IP, NAT, VPN, TCP/UDP 등 네트워크 구조와 원리의 명확한 이해
노트 오른쪽에 적은 것들이다.
- 노드를 구분하기 위한 주소가 IP다. IPv4는 8비트씩 4개(0~255), IPv6는 128비트다.
- IP는 외우기 어려우니 DNS(Domain Name System)가 도메인을 IP로 바꿔준다.
- IP를 받는 방법은 두 가지다. 직접 정해두는 고정 IP, 그리고 DHCP 서버가 연결할 때마다 나눠주는 동적 IP.
- 같은 네트워크 안에서 IP는 겹치면 안 된다. 그런데 사설 IP는 다른 네트워크라면 겹쳐도 된다.
- NAT(Network Address Translation) — 내부의 사설 IP와 외부의 공인 IP를 서로 바꿔준다. 안에서 밖으로 나가면 SNAT, 밖에서 안으로 들어오면 DNAT. 공인 IP 하나로 여러 노드가 인터넷을 쓸 수 있다.
- 서버 네트워크의 노드는 사설 IP를 쓴다. 외부에서 직접 접근할 수 없다.
- VPN — 떨어진 사설 네트워크를 안전하게 연결해서 하나의 네트워크처럼 쓴다.
- 네트워크는 계층으로 나뉜다. 애플리케이션(HTTP, FTP, SMTP), 전송(TCP, UDP), 네트워크(IP). 그리고 HTTP/3는 UDP 위에서 QUIC으로 TCP의 신뢰성과 TLS의 보안을 합쳤다.
프론트엔드만 할 때는 fetch 한 줄 뒤에서 이런 일이 일어나는 걸 몰라도 됐다. 지금은 아니다.
MSA를 그려보면 이 노트가 그대로 지도가 된다. 서비스들은 사설 네트워크 안에 두고 사설 IP로 서로 부른다. 밖에서 들어오는 길은 게이트웨이 하나만 연다. 서비스가 외부 API를 부를 때는 NAT를 거쳐 나간다. 그래서 외부 업체가 "호출하는 IP를 알려달라"고 하면 서버 IP가 아니라 NAT의 공인 IP를 알려줘야 한다.
외부 API 연동이 많은 플랫폼 엔지니어링 일에서 이런 질문은 생각보다 자주 나온다. 노트를 쓰면서 그 그림이 처음으로 머릿속에 그려졌다.
아키텍처 — 나누는 건 쉬운 부분이었다
MVC, 계층형, 마이크로서비스, DDD 등 자주 쓰는 서버 아키텍처 패턴 정리
마지막 챕터는 앞의 모든 이야기를 아키텍처로 묶는다.
어려운 건 나눈 다음이다. 이 책의 챕터들이 전부 그 질문에 대한 답이었다.
| 나눈 다음 생기는 질문 | 이 책에서 읽은 답 |
|---|---|
| 다른 서비스가 느려지면? | 타임아웃, 서킷 브레이커 |
| 호출이 실패하면 다시 보내도 되나? | 멱등성, 재시도 정책 |
| 서비스 사이의 데이터는 어떻게 맞추나? | 비동기 연동, 트랜잭션 아웃박스 |
| 누가 호출하는지 어떻게 믿나? | 인증과 인가, 토큰 서명 검증 |
| 서비스끼리는 어디서 말하나? | 사설 네트워크, NAT, 게이트웨이 |
모놀리식에서는 이 질문들이 아예 없었다. 함수 호출은 느려지지 않고, 하나의 트랜잭션이 전부를 묶어줬다. MSA로 간다는 건 그 공짜 보장을 하나씩 내려놓고, 대신 직접 설계하겠다는 뜻이다.
읽고 나서
이 책은 정답을 외우게 하는 책이 아니었다. 어디서 터지는지 미리 알게 해주는 책이었다.
그리고 그게 AI 시대에 개발자에게 필요한 바로 그 능력이다. 코드는 AI가 쓴다. 그런데 "여기 타임아웃 3초 걸어", "이건 기다리지 말고 아웃박스로 빼", "이 요청은 멱등하지 않으니까 재시도하지 마"라고 말하는 건 여전히 내 몫이다. 모르면 시킬 수 없고, 시키지 못하면 AI가 짠 코드가 맞는지도 판단할 수 없다.
Spring과 Java로 쓰인 책을 Node.js로 다시 써보면서, 결국 문제는 언어가 아니라는 것도 알게 됐다. 타임아웃도, 멱등성도, 아웃박스도 어느 언어로 짜든 똑같이 필요하다. 언어는 그걸 표현하는 방법만 다르다.
AI로 학습을 하게 되면 문제 해결에 본질인 '왜?' 를 놓치는 경우가 많다. 놓치는 이유는 AI가 말을 너무 잘한다. 정말 필요하지 않은데 AI가 그렇다고 하면 그렇다라고 말하는 경우가 빈번히 있다. 넓게보면 맞는 말이지만, 지금 내 상황에서 맞는 지 비교하면 아닌 경우도 많다. 그렇기 때문에 책을 통한 학습은 필요하다.