LIKE '%검색%'을 버리고 OpenSearch를 뜯어봤다
RDB의 LIKE 검색은 왜 한계에 부딪히는가. 역색인, Analyzer, BM25, dis_max까지 — OpenSearch가 검색어 하나를 처리하는 전체 흐름을 백엔드 개발자의 눈으로 따라간다.
회사 코드를 노출할 수 없으니, 이 글에서는 예시를 모두 이해하기 쉬운 도메인으로 변경했습니다.
실무에서 검색 시스템에 OpenSearch를 적용하면서 내부 동작을 공부하고 있다. 처음에는 "검색 빠르게 해주는 DB 아닌가?" 정도로 생각했다. 아니었다.
결론부터 말하면 — OpenSearch는 빠른 DB가 아니라, 검색을 위해 데이터를 미리 분석해서 역색인(inverted index)을 만들어두는 검색 엔진이다. 이 한 문장을 이해하는 데 꽤 오래 걸렸고, 이해하고 나니 mapping, analyzer, BM25, boost 같은 개념들이 전부 한 줄로 꿰어졌다.
이 글은 그 흐름을 처음부터 따라간다. MySQL 같은 RDB는 써봤지만 검색 엔진의 원리는 잘 모르는 백엔드 개발자를 대상으로 한다.
1. 시작은 LIKE 검색이다
검색 기능을 처음 만들 때 대부분 이렇게 시작한다.
SELECT *FROM documentsWHERE title LIKE '%개발 요청%' OR creator_name LIKE '%개발 요청%' OR description LIKE '%개발 요청%';데이터가 적을 때는 잘 돌아간다. 문제는 데이터가 쌓이면서 시작된다.
첫째, 느리다. LIKE '%keyword%'처럼 앞에 와일드카드가 붙으면 B-Tree 인덱스를 탈 수 없다. B-Tree는 값의 앞부분부터 정렬해서 찾아가는 구조인데, "중간에 이 문자열이 포함된 row"는 정렬 순서로 찾을 방법이 없다. 결국 풀 스캔이다. row가 백만 개면 백만 번 문자열 비교를 한다. (B-Tree가 왜 그렇게 동작하는지는 Real MySQL 8.0 정리 (1)에 정리해뒀다.)
둘째, 검색 품질이 없다. LIKE는 포함/미포함만 판단한다.
- "개발요청"으로 검색하면 "개발 요청"이 안 나온다. 띄어쓰기 하나에 실패한다.
- "요청 개발"처럼 어순이 바뀌어도 실패한다.
- 결과가 100건 나오면 어떤 게 더 관련 있는 문서인지 순위를 매길 수 없다.
성능은 인덱스 튜닝으로 어떻게든 버틴다 쳐도, 품질 문제는 RDB 구조 안에서 해결이 안 된다. 애초에 RDB는 "정확한 값을 저장하고 꺼내는 것"에 최적화된 시스템이지, "사람이 입력한 애매한 검색어에 가장 관련 있는 문서를 찾아주는 것"을 위해 설계되지 않았다.
OpenSearch는 이 문제를 정면으로 푼다. 데이터를 저장하는 시점에 미리 검색을 위한 형태로 분석해두는 것이다. 그 구조를 하나씩 따라가 보자.
2. Document와 Field
OpenSearch에서 데이터의 단위는 document다. RDB의 row에 대응한다.
{ "id": 1, "title": "개발 요청서", "creator_name": "김태호", "description": "검색 시스템 개발 요청"}| RDB | OpenSearch |
|---|---|
| Table | Index |
| Row | Document |
| Column | Field |
여기서 하나 짚고 갈 것이 있다. 검색은 document 전체를 하나의 문자열로 뭉쳐서 훑는 게 아니다. 검색 대상으로 지정된 각 field에 대해 쿼리가 수행된다. "title에서 찾을 것인가, description에서 찾을 것인가, 둘 다인가"가 검색 쿼리의 일부라는 뜻이다.
이게 왜 중요하냐면, 뒤에서 나올 boost("title 매칭은 description 매칭보다 5배 중요하다")나 multi-field 같은 개념이 전부 "field 단위로 검색한다"는 전제 위에 서 있기 때문이다.
3. Mapping — field를 어떻게 저장하고 검색할 것인가
RDB에 스키마가 있듯 OpenSearch에는 mapping이 있다. 각 field를 어떤 타입으로 저장하고, 어떻게 검색 가능하게 만들지 정의한다.
{ "mappings": { "properties": { "title": { "type": "text" }, "id": { "type": "long" } } }}여기서 가장 중요한 구분이 text와 keyword다.
- text — analyzer를 거쳐 잘게 쪼개진다. 전문 검색(full-text search)용이다.
- keyword — 분석하지 않고 원본 값 그대로 저장한다. 완전 일치(exact match), 정렬, 집계(aggregation)용이다.
"개발 요청서"라는 값이 text field에 들어가면 개발, 요청서 같은 조각으로 쪼개져서 색인되고, keyword field에 들어가면 "개발 요청서" 통째로 하나의 값으로 색인된다.
그래서 같은 검색어라도 결과가 다르다. keyword field에 "개발"로 검색하면 아무것도 안 나온다. 저장된 값은 "개발 요청서"라는 통짜 문자열 하나뿐이고, "개발"과 완전 일치하지 않기 때문이다.
4. Analyzer — 문자열이 token이 되기까지
text field의 핵심이 analyzer다. 다음 문자열이 저장된다고 하자.
검색 시스템 개발 요청이 문자열은 색인되기 전에 analyzer를 통과한다. analyzer는 세 단계 파이프라인이다.
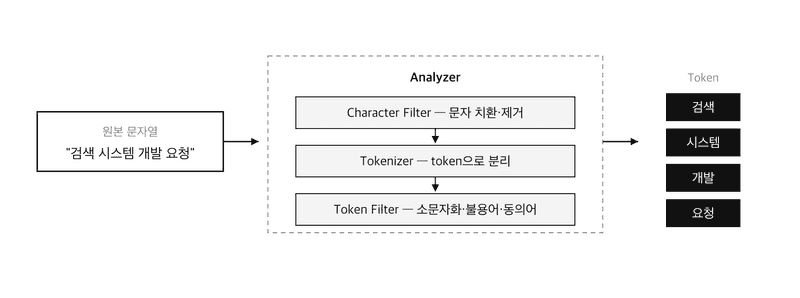
이 조각 하나하나가 token이다. 검색은 이 token 단위로 이루어진다.
언어마다 쓰는 analyzer가 다르다. 영어는 공백 기준으로 자르고 소문자화하는 standard analyzer로도 어느 정도 되지만, 한국어는 그렇게 안 된다. "검색합니다"를 공백으로 자르면 검색합니다 통짜 token이 되고, "검색"으로는 못 찾는다. 그래서 한국어에는 Nori 같은 형태소 분석기를 쓴다. Nori는 "검색합니다"를 검색 + 하 + ㅂ니다로 분해해서 어간을 뽑아낸다.
여기서 헷갈리기 쉬운 것 하나. 분석된 token은 검색용 색인에만 쓰인다. 원본 document는 _source에 그대로 보존된다. 검색 결과로 받는 JSON이 멀쩡한 원본인 이유다. 색인과 원본은 목적이 다르다 — 색인은 찾기 위한 자료구조고, _source는 보여주기 위한 데이터다.
5. Multi-field — 하나의 값, 여러 개의 색인
그런데 실무에서는 하나의 field를 한 가지 방식으로만 검색하지 않는다. title 하나를 놓고도 요구사항이 이렇게 갈라진다.
- 완전 일치로 찾고 싶다
- 한국어 형태소로 찾고 싶다
- 영어가 섞여 있으면 영어로도 찾고 싶다
ㄱㅂㅇㅊ같은 초성으로도 찾고 싶다- "발 요청"처럼 단어 중간 부분 문자열로도 찾고 싶다
analyzer는 field당 하나다. 그럼 어떻게 하나? 같은 원본 값을 여러 개의 subfield로 각각 다르게 색인한다. 이게 multi-field다.
title (원본: "개발 요청서")├── title.keyword → "개발 요청서" (완전 일치)├── title.korean → [개발, 요청서] (Nori 형태소)├── title.english → [...] (영어 analyzer)├── title.chosung → [ㄱㅂ ㅇㅊㅅ] (초성 변환)├── title.korean_ngram → [개발, 발요, 요청, ...] (부분 문자열)└── title.english_ngram → [...]document를 넣는 쪽에서는 title: "개발 요청서" 하나만 넣는다. OpenSearch가 색인 시점에 이 값을 subfield 개수만큼 각각의 analyzer에 통과시켜 따로따로 색인한다.
저장 공간을 더 쓰는 대신 검색의 자유도를 산다. "어떤 검색을 지원할 것인가"를 색인 설계 시점에 미리 결정해야 한다는 뜻이기도 하다. 이게 RDB와 가장 크게 다른 사고방식이었다. RDB는 일단 저장해두고 쿼리로 어떻게든 해보지만, 검색 엔진은 색인을 설계하는 순간 검색 능력이 결정된다.
6. 역색인 — 검색 엔진 성능의 핵심
이제 이 글에서 가장 중요한 자료구조가 나온다. token들은 어디에 어떻게 저장되는가?
RDB의 LIKE 검색은 모든 document를 순회하면서 내용에 keyword가 포함되어 있는지 하나씩 검사한다. document가 늘어날수록 선형으로 느려진다. 검색 엔진은 방향을 뒤집는다 — 색인 시점에 "token → 그 token을 가진 document 목록" 표를 만들어 둔다.
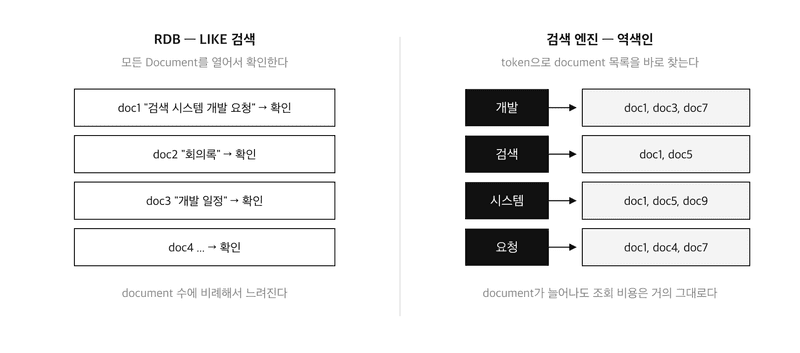
이게 역색인(inverted index)이다. "문서 → 단어들"이 아니라 "단어 → 문서들"이라서 역(inverted)이다. 책 맨 뒤의 찾아보기(index)와 정확히 같은 구조다. "트랜잭션이 나오는 페이지"를 찾으려고 책을 첫 장부터 읽는 사람은 없다. 찾아보기에서 "트랜잭션 → p.132, p.201"을 보고 바로 펼친다.
"개발"을 검색하면 모든 document를 읽는 게 아니라 역색인에서 개발 항목 하나를 찾아 [doc1, doc3, doc7]을 바로 얻는다. document가 백만 개든 천만 개든, 후보를 찾는 비용은 거의 변하지 않는다.
앞의 모든 개념이 여기로 수렴한다. analyzer가 필요한 이유는 역색인의 key인 token을 만들기 위해서고, multi-field는 하나의 값으로 여러 벌의 역색인을 만드는 것이다.
7. 검색어도 분석된다
여기서 자연스러운 의문이 생긴다. 역색인의 key는 token인데, 사용자가 입력한 검색어 "개발 요청"은 문장이다. 이걸 어떻게 매칭하나?
답은 단순하다. 검색어도 같은 analyzer를 통과한다.
검색어: "개발 요청" ↓ analyzer["개발", "요청"] ↓역색인 조회: 개발 → [doc1, doc3, doc7] 요청 → [doc1, doc4, doc7]색인할 때와 검색할 때, 같은 분석기로 같은 형태의 token을 만들어야 매칭이 성립한다. 색인은 Nori로 하고 검색어는 standard로 분석하면 token이 어긋나서 검색이 안 된다. 실무에서 "분명 데이터가 있는데 검색이 안 돼요"의 상당수가 이 불일치다.
전체 흐름을 그리면 이렇다. 이 글에서 이 그림 하나만 기억해도 된다.
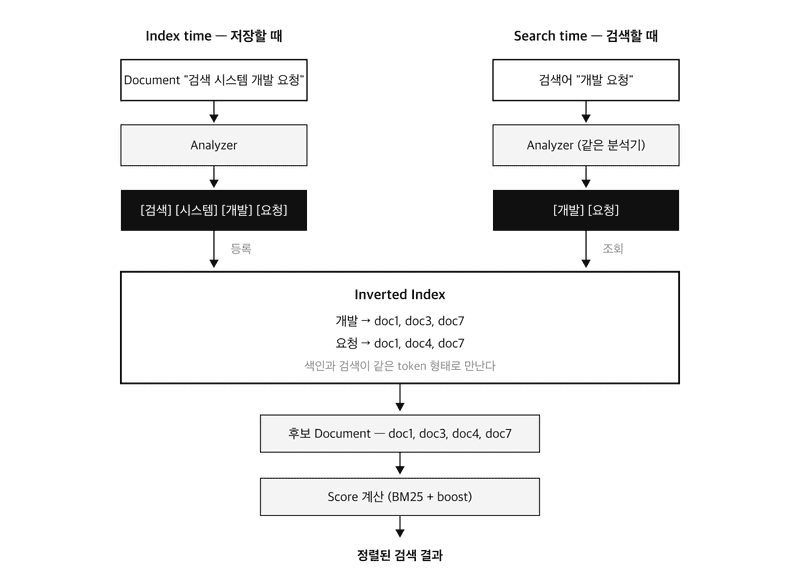
색인과 검색이 같은 파이프라인의 양 끝에서 만난다. OpenSearch의 거의 모든 개념은 이 그림 어딘가에 꽂힌다.
8. match와 multi_match
이제 실제 쿼리를 보자. 한 field를 검색하는 가장 기본 쿼리가 match다.
{ "query": { "match": { "title": "개발 요청" } }}이 쿼리가 하는 일이 정확히 7장의 Search time 흐름이다. "개발 요청"을 title field의 analyzer로 분석하고, 나온 token들로 역색인을 조회한다.
여러 field를 한 번에 검색하려면 multi_match를 쓴다.
{ "query": { "multi_match": { "query": "개발 요청", "fields": ["title", "uid", "creator_name", "description"] } }}글 맨 앞의 LIKE ... OR LIKE ... OR LIKE ... SQL과 겉모습은 같은 일을 한다. 하지만 내부는 다르다. field별로 각각 역색인을 조회하고, field별 매칭 결과를 종합해서 document마다 relevance score를 계산한다.
이 "종합하는 방식"에 type이 있다. 대표적인 둘만 보면:
- best_fields (기본값) — 여러 field 중 가장 잘 맞은 field 하나의 점수를 중심으로 평가한다. "개발 요청"이 title에 통째로 매칭된 문서가, 여러 field에 조각조각 걸친 문서보다 높게 나온다.
- cross_fields — 여러 field를 하나의 논리적인 검색 공간처럼 취급한다. 검색어 token들이 field에 나뉘어 있어도 좋게 평가한다. "김태호 개발"처럼 creator_name의 token과 title의 token이 섞인 검색어에 맞다.
9. BM25 — 점수는 어디서 오는가
방금부터 계속 score라는 말이 나왔다. OpenSearch는 포함/미포함만 판단하지 않는다. 매칭된 document마다 얼마나 관련 있는지를 점수(_score)로 계산하고, 그 순서로 결과를 정렬한다. LIKE 검색에는 없던 능력이다.
기본 알고리즘이 BM25다. 수식은 생략하고 직관만 잡자. 점수가 올라가는 대표적인 이유는 이렇다.
- 검색어 token이 document에 등장한다 — 기본 전제.
- 그 token이 전체 문서에서 희귀하다 — "개발"은 개발 문서 시스템에 수만 번 나오니 변별력이 없다. "김태호"는 몇 건 안 나오니 매칭되면 강한 신호다. 희귀한 token일수록 점수가 크다. (IDF — 역문서빈도)
- 그 document 안에서 token이 자주 등장한다 — 같은 "검색"이라도 한 번 스친 문서보다 여러 번 다룬 문서가 높다. 단, 무한히 오르지 않고 포화된다. 100번 나온다고 10번 나온 것의 10배가 되진 않는다. (TF 포화)
- field가 짧다 — 10단어짜리 title에서 매칭된 것과 1,000단어짜리 description에서 매칭된 것은 밀도가 다르다. 짧은 field에서의 매칭이 보정을 받는다.
- boost가 걸려 있다 — 바로 다음 장.
정리하면 BM25는 "이 단어가 이 문서를 얼마나 특징짓는가"를 수치화한다. 이 수치가 있어야 결과 100건 중 무엇을 맨 위에 놓을지 결정할 수 있다. 검색 엔진이 '조회'가 아니라 '순위 매기기' 시스템인 이유다.
10. Boost — 모든 field가 평등하지는 않다
field마다 검색에서의 무게가 다르다. title에 "개발 요청"이 있는 문서와, 긴 description 중간 어딘가에 "개발 요청"이 스치는 문서. 사용자가 원하는 건 대부분 전자다.
이 의도를 boost로 표현한다.
{ "multi_match": { "query": "개발 요청", "fields": [ "title^5", "uid^3", "creator_name^2", "description" ] }}title^5는 title에서 발생한 매칭의 점수를 5배로 평가하라는 field boost다. 같은 "개발"이라는 token 매칭이라도 어느 field에서 발견됐는지에 따라 최종 _score 기여도가 달라진다.
field boost 말고 query 절 자체에 boost를 거는 것도 가능하다. "이 쿼리 조건으로 매칭된 건 통째로 더 중요하게 봐라"를 표현할 때 쓴다. 뒤에 나올 constant_score가 그 극단적인 형태다.
boost 값 자체에 정답은 없다. ^5가 맞는지 ^3이 맞는지는 실제 검색 결과를 보면서 조정하는 튜닝의 영역이다.
11. 검색 전략은 multi_match 하나로 끝나지 않는다
여기까지가 기본기다. 그런데 실무 검색은 multi_match 한 방으로 안 끝난다. 사용자가 "개발 요청"을 입력하는 순간, 그 의도는 여러 가지일 수 있다.
"개발 요청" │ ├─ Exact Match → keyword field + term │ (정확히 이 제목의 문서를 찾는 중일 수 있다) │ ├─ Prefix Match → keyword field + prefix │ (제목의 앞부분만 기억하고 있을 수 있다) │ ├─ 일반 전문 검색 → multi_match / best_fields │ (관련 문서를 넓게 찾는 중일 수 있다) │ ├─ Cross Field 검색 → multi_match / cross_fields │ (제목+작성자를 섞어 입력했을 수 있다) │ ├─ 오타 허용 → fuzzy │ ("개빌 요청"이라고 쳤을 수 있다) │ ├─ 부분 문자열 → wildcard / ngram field │ (단어 중간 조각만 기억할 수 있다) │ └─ 초성 검색 → chosung field ("ㄱㅂ ㅇㅊ"만 치고 싶을 수 있다)5장에서 만든 subfield들이 여기서 전부 소비된다. multi-field가 "여러 벌의 색인"이었다면, 검색 전략은 "여러 벌의 쿼리"다.
이 전략들을 다 켜면 recall(빠짐없이 찾기)은 올라가지만 precision(관련 있는 것만 찾기)은 떨어진다. ngram과 fuzzy는 노이즈를 많이 만든다. 반대로 exact match만 쓰면 precision은 완벽하지만 recall이 바닥이다. OpenSearch를 잘 쓴다는 건 이 전략들을 조합해서 precision과 recall의 균형점을 서비스에 맞게 잡는 일이다.
12. bool.should와 dis_max — 전략을 조합하는 법
여러 쿼리를 조합하는 대표적인 방법이 둘 있다.
bool.should — 여러 조건 중 하나라도 맞으면 매칭시키고, 맞은 조건들의 점수를 합산 계열로 반영한다. 여러 전략에 동시에 걸린 문서가 유리해진다.
dis_max(disjunction max)는 여러 쿼리 중 가장 높은 점수 하나를 중심으로 문서를 평가한다.
{ "dis_max": { "queries": [ { "constant_score": { "..." : "exact match 전략" } }, { "multi_match": { "..." : "전문 검색 전략" } }, { "match": { "..." : "fuzzy 전략" } } ], "tie_breaker": 0 }}왜 합산이 아니라 max를 쓰나? 합산은 "얕은 매칭 여러 개"가 "깊은 매칭 하나"를 이겨버리는 문제가 있다. fuzzy로도 걸리고 ngram으로도 걸리고 부분 매칭도 된 애매한 문서가, title에 정확히 매칭된 문서보다 위로 올라온다. dis_max는 "가장 강한 신호 하나로 평가하겠다"는 선언이다. tie_breaker를 0보다 크게 주면 나머지 쿼리 점수도 그 비율만큼 살짝 반영할 수 있다.
실무에서 유용했던 패턴 하나 — exact match에는 아예 고정된 높은 점수를 주고, 나머지 BM25 기반 전략들과 dis_max로 경쟁시키는 것이다. 정확히 일치하는 문서는 무조건 이기고, 아니면 BM25 순위로 흘러간다.
13. constant_score — BM25를 무시하고 싶을 때
그 "고정된 높은 점수"를 만드는 도구가 constant_score다.
{ "constant_score": { "filter": { "term": { "title.keyword": "개발 요청" } }, "boost": 100 }}filter 조건에 맞는 문서에 BM25 계산 없이 boost 값을 점수로 그대로 준다. "제목이 검색어와 완전히 일치하면 무조건 100점"이다.
왜 필요한가? BM25 점수는 상대적이다. 문서 분포에 따라 출렁인다. "완전 일치 문서는 항상 맨 위"라는 요구사항을 BM25 튜닝으로 보장하려면 피곤하다. constant_score로 BM25 점수 대역보다 확실히 높은 고정 점수를 박아버리면, exact match가 검색 결과 상단에 안정적으로 고정된다.
부수 효과도 있다. filter 문맥은 점수 계산을 생략하므로 캐싱이 가능하고 빠르다.
14. min_score — 나온 걸 다 보여줄 필요는 없다
역색인과 여러 전략으로 후보를 넓게 모으면, 하위권에는 "걸리긴 걸렸는데 사실상 관련 없는" 문서들이 붙는다. token 하나가 우연히 스친 문서들이다.
min_score로 자른다.
{ "min_score": 10, "query": { "..." : "..." }}전체 흐름에 자르는 단계가 하나 추가되는 것이다.
검색 후보 생성 (역색인 조회) ↓relevance score 계산 (BM25 + boost + constant_score) ↓min_score 이하 제거 ↓score 기준 정렬 ↓결과 반환이것도 결국 precision/recall 조절이다. min_score를 올리면 노이즈가 사라지는 대신 애매하게 관련 있던 문서도 같이 사라진다. 내리면 그 반대다. 적정값은 서비스의 점수 분포를 실제로 보면서 정한다.
15. 검색 모드 — 정답은 하나가 아니다
여기까지 오면 자연스러운 결론이 나온다. 최고의 검색 알고리즘이라는 건 없다. 목적에 맞는 검색 구성이 있을 뿐이다.
같은 시스템 안에서도 검색의 목적이 다르다.
strict→ 정확도 우선. 노이즈를 적극적으로 제거→ fuzzy·ngram 끄고 min_score 높게
store→ 고객이 원하는 상품/문서가 상단에 와야 한다→ phrase / exact match 비중을 높게
backoffice→ 운영자는 뭐라도 찾아야 한다. 못 찾는 게 최악→ recall 우선. ngram·초성·부분 매칭 다 켠다
fuzzy→ 오타가 많은 입력 환경→ fuzziness 허용
운영자 어드민에서는 "검색 결과 0건"이 최악이라 recall을 최대로 벌리고, 고객용 스토어에서는 이상한 결과가 섞이는 게 최악이라 precision을 조인다. 같은 데이터, 같은 색인 위에서 쿼리 구성만 달라진다.
16. Dynamic Query Builder — 이걸 서비스마다 짜게 할 수는 없다
마지막은 아키텍처 이야기다. 위에서 본 것처럼 제대로 된 검색 쿼리 하나는 꽤 복잡하다. dis_max 안에 constant_score, multi_match 여러 벌, fuzzy, subfield 선택, boost, min_score까지. 이 Query DSL을 검색이 필요한 모든 서비스가 각자 작성한다면 재앙이다.
그래서 중간에 검색 플랫폼 계층을 둘 수 있다.
Application │ │ q="개발 요청" │ search_fields=title,creator_name,... │ search_mode=backoffice │ min_score=10 ▼Search Platform (Dynamic Query Builder) │ ├─ Schema 조회 (이 index에 어떤 field/subfield가 있는가) ├─ 검색어 언어 감지 (한국어면 korean subfield, 영어면 english) ├─ 검색 field/subfield 선택 ├─ search mode에 맞는 전략 조합 선택 ├─ boost 적용 ├─ filter 적용 ├─ Query DSL 생성 ▼OpenSearch │ ├─ Inverted Index 조회 ├─ BM25 / constant_score 계산 ├─ min_score 적용 ├─ sort ▼Search Results각 서비스는 "무엇을(q), 어디서(fields), 어떤 성격으로(mode)"만 선언하고, Query DSL 생성은 플랫폼이 맡는다. 검색 전략과 scoring 정책이 중앙에서 관리되니, "backoffice 검색의 초성 매칭 boost를 조정하자" 같은 변경이 서비스 코드 수정 없이 한 곳에서 끝난다.
이름 때문에 헷갈리지 말 것 — 여기서 말하는 Dynamic Query Builder의 dynamic과 OpenSearch의 dynamic mapping은 전혀 다른 개념이다.
- Dynamic Query Builder → 요청 파라미터에 따라 검색 Query DSL을 동적으로 생성하는 애플리케이션 계층
- Dynamic Mapping → 처음 보는 field가 들어왔을 때 OpenSearch가 mapping을 자동 추론해서 만들어주는 기능
정리 — 검색어 하나의 일생
글 전체를 그림 하나로 접는다.
[색인]Document 저장 ↓Mapping (text? keyword? subfield?) ↓Analyzer (Nori, ngram, chosung, ...) ↓Token ↓Inverted Index────────────────────────────[검색]검색어 입력 ↓Query Analyzer ↓Token ↓match / multi_match / exact / fuzzy / ngram ... ↓역색인에서 후보 Document 확보 ↓BM25 + Boost + Constant Score ↓_score ↓min_score로 하위 제거 ↓Sort ↓검색 결과LIKE 검색이 "저장된 걸 그때그때 훑는 것"이라면, OpenSearch는 "찾을 것을 미리 준비해두는 것"이다. 그 준비가 mapping이고 analyzer고 역색인이다. 그리고 찾은 것에 순위를 매기는 게 BM25고, 그 순위에 서비스의 의도를 싣는 게 boost, dis_max, constant_score, min_score다.
처음에는 Query DSL 문법이 복잡해 보였는데, 지금은 반대로 느낀다. 문법은 표면이고, 그 아래에 "색인 시점에 무엇을 준비했고, 검색 시점에 무엇과 매칭되는가"라는 단순한 구조가 있다. 이 구조가 보이기 시작하면 처음 보는 쿼리 옵션도 대충 어디에 꽂히는 물건인지 감이 온다.
역시 도구를 잘 쓰는 것보다, 도구가 왜 그렇게 생겼는지 이해하는 게 먼저다.